浏览器翻译:如何只翻译真正想读的内容
真正动手做浏览器翻译扩展之前,我一直以为视频字幕翻译会是最难的一关。
难点不只是发出多少个并发请求,而是怎样让翻译速度尽量跟上视频的播放节奏:字幕不断出现,视频不会停下来等译文。如果处理慢了,翻译即使准确,实际体验也不会好。
正因为一直觉得这件事很难,我最初把视频翻译放到了比较靠后的位置。
OnlyTranslate 一开始也不是一个宏大的产品计划。我只是想做一个方便自己使用、没有广告,功能又正好符合自己阅读习惯的浏览器翻译扩展。
我平时看得最多的是文章和帖子。真正需要翻译的,通常只是标题、正文和评论;菜单、标签、导航栏、分享按钮这些内容,我既不关心,也不希望它们被改动。
整页翻译虽然覆盖得更全,却会打乱页面原本清晰的视觉层级。导航和按钮突然都变成长短不一的译文,页面看起来会很不自然。我又有点强迫症,所以这种“不影响功能,但就是不够干净”的体验一直让我很难受。
当时我很自然地想到:如果翻译扩展只处理我真正想读的标题、正文和评论,其他界面保持原样,我一定会更愿意一直开着它。
于是,“只翻译阅读内容”反而成了我最早开始做的功能之一。
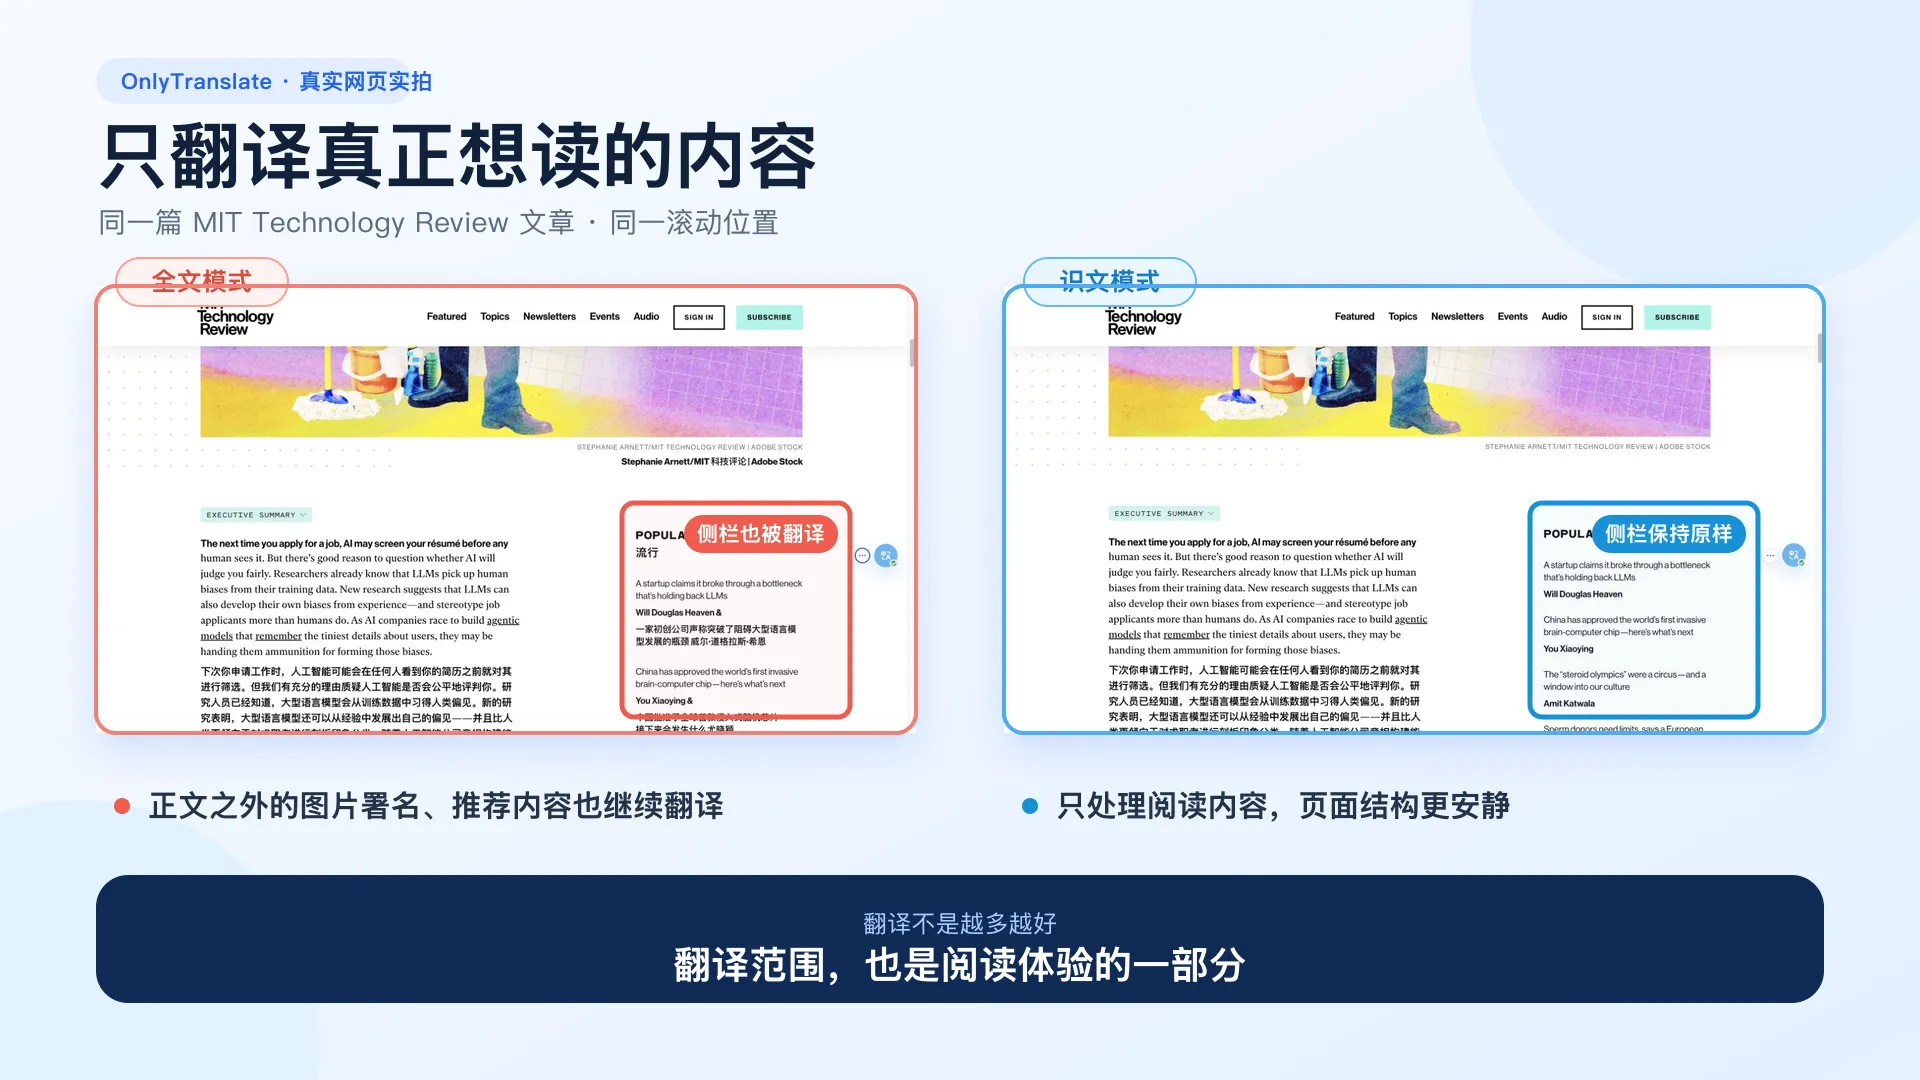
同一篇 MIT Technology Review 文章、同一个滚动位置:全文模式会继续处理图片署名和右侧推荐内容;识文模式则把翻译范围收敛在主要阅读内容中。
真正的问题不是怎么翻译,而是翻译谁
Section titled “真正的问题不是怎么翻译,而是翻译谁”这个功能听上去似乎并不复杂:找到网页正文,然后翻译。
最直接的办法是遍历页面上的 <p>、<h1>、<h2> 和 <li>。它在结构简单的博客上确实能工作,但换几个网站就会遇到问题:
- 导航、推荐卡片和评论操作区也会使用这些标签;
- 一些正文放在多层、没有语义的
<div>中; - 标题、摘要和正文可能属于不同的兄弟容器;
- SPA 会在首次扫描结束后继续插入评论和新内容;
- 父容器和子段落可能同时被选中,导致重复翻译。
另一个看起来更稳妥的办法是只寻找 <article> 或 <main>。
但语义标签同样不是真相。列表页可能包含几十个 <article>;新闻直播页可能只有一个很宽的 <main>,里面同时放着直播正文、侧栏和推荐;有些老式网页甚至还在用表格布局。
我逐渐意识到,这不是写一个万能选择器的问题,而是一条需要逐层降低误判概率的决策链。
目前的处理过程可以概括为:
- 定位最可能的主阅读区域;
- 从中收集标题、段落、引用、列表等候选内容;
- 排除导航、元数据、分享和推广噪音;
- 使用站点画像处理特殊页面结构;
- 合并重复目标,确定最终翻译节点;
- 监听后续 DOM 变化,对新内容做增量扫描;
- 智能识别结果为空时,逐级回退到更宽松的模式。
下面只展开其中最容易出问题的三部分。
第一关:正文不一定就是一个 <article>
Section titled “第一关:正文不一定就是一个 <article>”识别开始时,我会先尝试寻找高置信度的语义根。
如果页面只有一个 <article>,而且它有足够的文本、链接占比不高,也没有明显噪音,就优先采用它。这里故意要求“只有一个”,因为多个 <article> 往往意味着列表页。
找不到合适的 <article> 时,再检查唯一的 <main>。除了文本量,它还要有主要标题,并且不能同时包含多个互相竞争的强阅读区域。否则很容易把“文章正文 + 评论区 + 推荐区”一起选进来。
语义标签仍然不可信时,才进入自底向上的文本密度评分:
- 从段落、标题、引用等叶子节点开始;
- 根据文本长度和自然语言特征累计分数;
- 把分数按权重传递给父级容器;
- 再用链接密度、标签类型和结构名称修正结果。
这里有一个很重要的取舍:class 和 id 只能作为证据,不能直接作为结论。
例如 article-content 是正向信号,sidebar、related 和 share 是负向信号。但真实网页的命名经常很混乱,一个包含完整文章的容器也可能带有 share-story 这样的类名。
如果看到 share 就整块跳过,减少了一点分享按钮误译,却可能让整篇正文消失。因此,当节点有多个完整句子、链接和按钮占比又很低时,文字本身的证据应该高于类名。
找到正文容器之后,还不能马上结束。文本密度最高的节点通常只包住正文,标题和摘要可能在它的上一个兄弟节点中。
所以系统还会保守地向上寻找“内容外壳”:标题必须出现在正文之前,扩大后的文本量和链接密度不能失控,也不能把多个文章或侧栏一起带进来。
这一步解决的是一个很常见、也很影响体验的问题:正文翻译了,文章标题却还留在原文。
第二关:“跳过当前节点”和“跳过整棵子树”不是一回事
Section titled “第二关:“跳过当前节点”和“跳过整棵子树”不是一回事”我最早把过滤结果设计成布尔值:翻译,或者跳过。
后来发现这不够。一个节点不适合作为翻译目标,不代表它里面的所有内容都没有阅读价值。
现在过滤器会返回三种结果:
type ContentFilterDecision = | 'keep' | 'skip-self' | 'skip-subtree'keep:正常参与翻译;skip-self:当前容器像元数据、分享条或推荐模块,但不武断地否定所有后代;skip-subtree:导航、表单、弹窗等明确的界面区域,整棵子树都不再扫描。
这套过滤会综合判断文本长度、完整句子、链接密度、按钮数量、交互文字占比,以及节点是否像段落、标题、引用或图注。
以分享区域为例,真正的分享条通常是短文本、高交互密度的一组按钮;如果一个带有 share 类名的容器里存在多个可读段落,它更可能只是命名碰巧撞上了规则。
同样,标签云和文章列表都可能包含很多链接。区别在于前者通常由大量短文本组成,后者可能有完整标题和摘要。只统计链接数量,很容易把两者一起过滤掉。
因此,“什么应该翻译”和“什么不该翻译”需要分别收集证据,再在最终决策层汇合。
第三关:动态页面不能一变化就全页重扫
Section titled “第三关:动态页面不能一变化就全页重扫”初次识别正确,并不代表任务已经结束。
评论、展开卡片、新闻直播更新和无限滚动内容,都可能在翻译开始后才被插入页面。为此我使用 MutationObserver 监听 DOM 变化。
但如果每收到一条 mutation 就马上深度扫描,高频更新页面可能在一帧内触发数百次祖先回溯和子树遍历。最后还没来得及翻译,正文识别本身就先把主线程占满了。
目前的处理思路是:
- Observer 回调只做廉价过滤和根节点收集;
- 变化节点先放进
Set去重; - 使用短时间防抖,批量执行扫描;
- 限制单批处理的变化根节点数量;
- 给动态扫描设置独立的元素预算;
- 只处理仍在当前翻译作用域内的节点;
- 跳过扩展自己插入的译文,避免触发循环;
- 缓存文本、过滤结果和可见性,DOM 变化时只失效相关子树。
这部分让我意识到:正文识别不仅是准确率问题,还是一个主线程性能问题。
通用规则之外,必须给特殊网站留一个出口
Section titled “通用规则之外,必须给特殊网站留一个出口”GitHub README、Reddit 帖子、Hacker News 评论和新闻直播页都包含阅读内容,但 DOM 结构完全不同。
如果每遇到一个网站,就在通用过滤器里增加一个域名判断,规则很快会变成无法维护的巨大 if/else。
所以我把特殊处理拆成独立的站点画像。它可以明确允许或跳过某些目标,补充主内容之外的评论和标题,拆分特殊容器,或者指定双语译文应该插入到哪里。
通用规则负责默认行为;站点画像只处理有真实页面证据的例外。
这样修复一个网站时,不必为了命中特定 DOM 而放宽全局规则,降低其他网站被连带影响的风险。
如何证明修好网站 A,不会弄坏网站 B
Section titled “如何证明修好网站 A,不会弄坏网站 B”正文识别最容易发生的回归就是:一个网站不再漏译了,另一个网站的菜单却突然开始翻译。
只靠人工打开几个网页很难长期发现这些问题,所以我把遇到的特殊结构逐步缩成 fixture:
- 一份最小化 HTML,保留导致问题的 DOM;
- 一份 JSON,声明正文根、必须包含的目标和必须排除的目标。
例如,一个直播页案例可以只描述:
{ "contentRoot": "main", "include": ["live-title", "live-headline", "live-paragraph"], "exclude": ["left-rail", "share-button"]}目前项目中共有 53 个翻译目标 fixture,覆盖老式表格文章、新闻直播页、Reddit 帖子和评论、GitHub README 与 Issue、Substack 文章、长篇 changelog,以及智能识别过严时的回退路径。
对于动态 DOM、MutationObserver、译文插入位置和扫描性能,则单独使用代码级测试。
这些测试的价值不只是保证现在的结果正确,更重要的是保存每次误判背后的经验。
我现在比较确定的三件事
Section titled “我现在比较确定的三件事”第一,语义标签、类名和文本长度都只是证据,没有一个信号可以单独代表正文。
第二,通用规则要保守,站点例外要隔离。为了修一个网站而不断放宽全局规则,通常会把问题转移到更多网站。
第三,智能识别必须有回退路径。网页结构没有统一标准,启发式系统不可能永远猜对。当前识文结果为空时,系统会先在正文区域内使用更宽松的规则,仍然为空再回到全页扫描;用户也可以主动切换到全页模式。
好的体验不是假装算法永远正确,而是猜错时仍然有一个可理解、可操作的下一步。
OnlyTranslate 是我正在开发的一款开源双语阅读浏览器扩展,支持网页正文、视频字幕和本地 EPUB。本文提到的正文识别和翻译目标选择逻辑都已经在项目中实际使用,相关代码和测试也已开源:
如果你也在处理浏览器扩展、DOM 内容抽取或动态页面扫描,欢迎分享你遇到的特殊页面结构。遇到只译漏译或误译的网页,也可以附上最小 DOM 示例提交 Issue。
如果这个项目或这篇文章对你有帮助,也欢迎 Star 关注后续演进。